

Modular - 统一AI推理平台
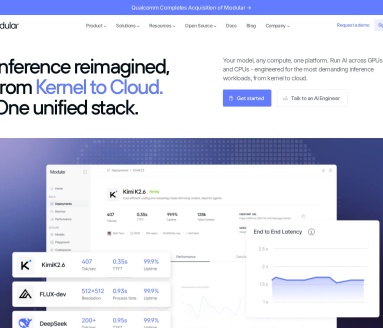
Modular 是一个面向开发者和企业的高性能AI推理基础设施平台,提供从GPU内核到云端API的全栈优化方案,支持跨硬件部署大语言模型。
网站介绍
Modular(官网:modular.com)是一家成立于2022年的AI基础设施公司,专注于构建统一的AI推理平台。该平台旨在解决当前AI推理生态中工具碎片化、硬件适配复杂、性能优化困难等核心痛点,为开发者提供从底层GPU内核编写到上层API端点部署的一站式解决方案。Modular 面向AI工程师、机器学习开发者、企业技术团队以及对高性能AI推理有需求的用户群体,帮助他们在不同硬件上高效运行大语言模型和多模态模型。
核心功能/栏目
1. MAX Serving(推理服务框架):高性能、硬件无关的模型推理服务框架,兼容OpenAI API接口,支持一键部署模型并提供比vLLM高2倍的推理性能。
2. MAX Modeling(模型运行接口):内置1000+主流模型(如DeepSeek、Kimi等),提供类似PyTorch的模型API,支持快速移植和运行自定义模型。
3. Mojo 编程语言:Modular自研的高性能系统级编程语言,专为AI和异构计算设计,用于编写和优化GPU内核,实现跨加速器的极致性能。
4. Modular Cloud(云端推理服务):提供共享端点、专属端点和自定义模型部署三种云端推理方案,支持NVIDIA和AMD GPU,按用量计费。
5. 多硬件兼容:原生支持NVIDIA、AMD、Intel、ARM及Apple Silicon等多种硬件平台,实现同一模型、同一代码库在不同芯片上无缝运行。
6. GPU内核库:提供数百个基于Mojo编写的先进可组合GPU内核,开发者可直接使用或在此基础上扩展自定义内核。
推荐优势/特点
1. 全栈统一架构:从GPU内核到云端API采用统一技术栈,避免了传统AI推理中多工具拼接带来的兼容性和维护问题,降低系统复杂度。
2. 真正的硬件可移植性:同一套代码可在NVIDIA、AMD、Intel、ARM、Apple Silicon等不同硬件上运行,无需针对每种芯片单独适配,大幅降低多平台部署成本。
3. 显著的性能提升:官方数据显示,在统一技术栈上可实现2倍推理性能提升,同时通过更高的GPU利用率和动态硬件选择,帮助用户节省约50%的推理成本。
4. 开发者友好:提供OpenAI兼容API,现有基于OpenAI SDK开发的应用可快速迁移;Mojo语言语法接近Python,学习门槛较低。
5. 灵活的部署方式:支持在Modular托管云端运行,也可部署到用户自有的VPC(虚拟私有云)环境中,满足不同企业的安全和合规需求。
使用方法/入口指引
1. 访问官网:打开浏览器,访问 https://www.modular.com 进入Modular官方网站。
2. 注册账号:点击页面中的"Get Started"或注册入口,使用邮箱创建Modular账号并获取API Key。
3. 选择服务:根据需求选择云端推理服务(共享端点、专属端点或自定义模型部署),或直接下载MAX框架在本地部署。
4. 调用模型:使用OpenAI兼容的Python SDK,将base_url替换为Modular提供的端点地址,填入API Key即可调用DeepSeek、Llama等主流模型。
5. 学习文档:官网提供详细的开发者文档、API参考和示例代码,建议新手从Quickstart教程开始入门。
同类/相关网站推荐
1. Hugging Face(huggingface.co):全球最大的开源AI模型社区和推理平台,提供模型托管、推理API和模型部署服务。
2. Together AI(together.ai):开源模型推理和托管平台,支持100+开源模型调用,注册赠送免费额度。
3. Groq(groq.com):专注超高速AI推理的平台,基于自研LPU芯片,推理速度极快,提供免费使用额度。
4. vLLM(vllm.ai):开源的大语言模型推理和服务框架,以高吞吐量和高效推理著称,是Modular MAX的主要对标产品之一。
5. NVIDIA NIM(build.nvidia.com):英伟达官方提供的AI推理微服务平台,集成多种主流模型的优化推理端点。
提示:若发现您的权益受到侵害,请立即联系客服,我们会尽快为您处理
类似网站

CodeSandbox
全球知名在线代码编辑器与云端开发平台,浏览器中即时编写/预览/分享前端项目
Sky-code
code-AI智能编程工具,提供代码生成/补全/优化等功能,辅助开发者高效编码

GraphQL Editor
可视化GraphQL Schema编辑与API设计平台,拖拽式构建GraphQL API,提升后端开发效率

Diagramming AI
AI智能图表绘制工具,自然语言描述自动生成流程图/架构图/思维导图/UML图

ZZZ Code AI
在线AI编程问答工具,输入问题秒出代码方案和详细解释,开发者随身编程百科

JetBrains IDE
全球开发者首选IDE全家桶(IntelliJ/PyCharm/WebStorm等),智能补全+重构+调试一站式开发

Visual Studio(微软)
微软旗舰级集成开发环境,支持C#/C++/Python/Web等全栈开发,企业级IDE标杆

Metabob
AI驱动的代码审查与Bug检测工具,基于图神经网络分析Python代码质量,自动发现潜在缺陷

Pgrammer
AI驱动的编程刷题练习平台,智能出题+AI解题+代码优化,程序员面试准备神器